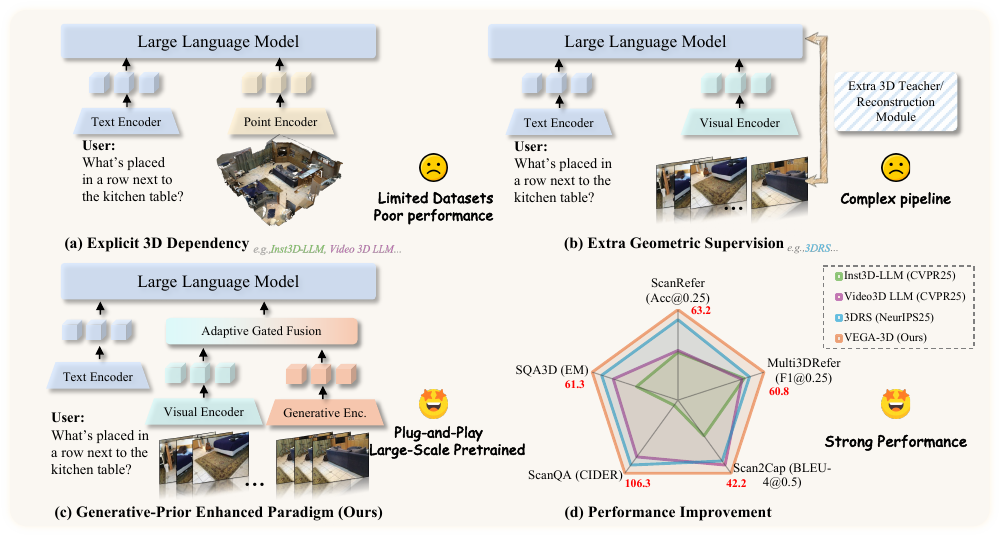
VEGA-3D extracts implicit spatial priors from pretrained video generation models and integrates them with semantic representations for 3D scene understanding, spatial reasoning, and embodied manipulation.
@inproceedings{wu2026vega,title={Generation Models Know Space: Unleashing Implicit 3D Priors for Scene Understanding},author={Wu, Xianjin and Liang, Dingkang and Feng, Tianrui and Xia, Kui and Zhang, Yumeng and Li, Xiaofan and Tan, Xiao and Bai, Xiang},booktitle={European Conference on Computer Vision (ECCV)},year={2026},}
Don’t Throw Away the Solution: Reusing Denoising Trajectories for Fast Robot Control
Xianjin Wu, Xian Li, Jianxiang Tang, Dingkang Liang, and Xiang Bai
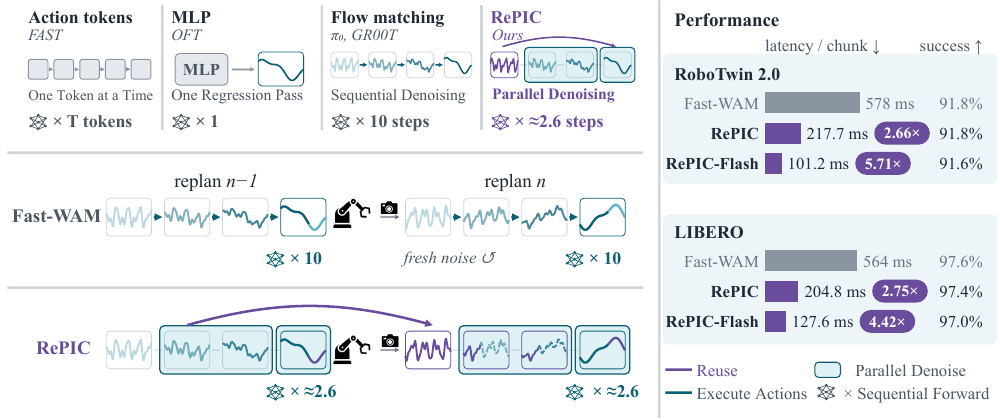
RePIC accelerates flow-based robot policies without retraining by reusing solver trajectories across consecutive replans and parallelizing denoising.
@unpublished{wu2026repic,title={Don't Throw Away the Solution: Reusing Denoising Trajectories for Fast Robot Control},author={Wu, Xianjin and Li, Xian and Tang, Jianxiang and Liang, Dingkang and Bai, Xiang},year={2026},note={arXiv version forthcoming},}
TurboVLA: Real-Time Vision-Language-Action Model at 32 Hz on an RTX 4090 with <1 GB VRAM
Hengyi Xie*, Chenfei Yao*, Xianjin Wu, Yingying Zhu, Dingkang Liang, Xiang Bai, and Han Ding
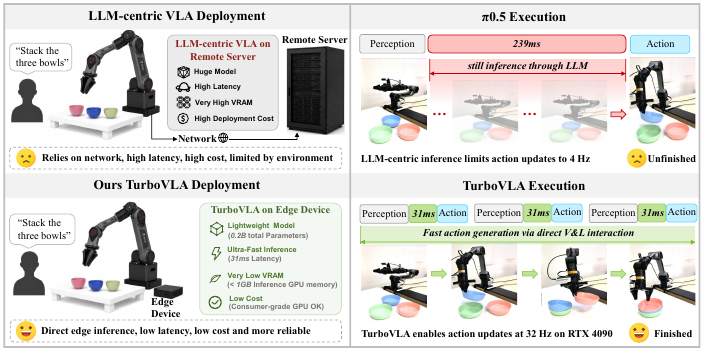
TurboVLA directly connects visual and language representations to a compact action decoder, enabling efficient robotic manipulation with 0.2B parameters and 31.2 ms policy latency on an RTX 4090.
@article{xie2026turbovla,title={TurboVLA: Real-Time Vision-Language-Action Model at 32 Hz on an RTX 4090 with <1 GB VRAM},author={Xie, Hengyi and Yao, Chenfei and Wu, Xianjin and Zhu, Yingying and Liang, Dingkang and Bai, Xiang and Ding, Han},journal={arXiv},year={2026},}
The Winning Solution for Track 1 of the 2026 AI City Challenge: Gauge Canonicalization for Multi-Camera 3D Perception
Xianjin Wu*, Heng Fang*, Xuanyang Xi, Yiping Tang, Di Xu, Xiang Bai, and Dingkang Liang
In ECCV Workshop: 10th AI City Challenge, Oral, 2026
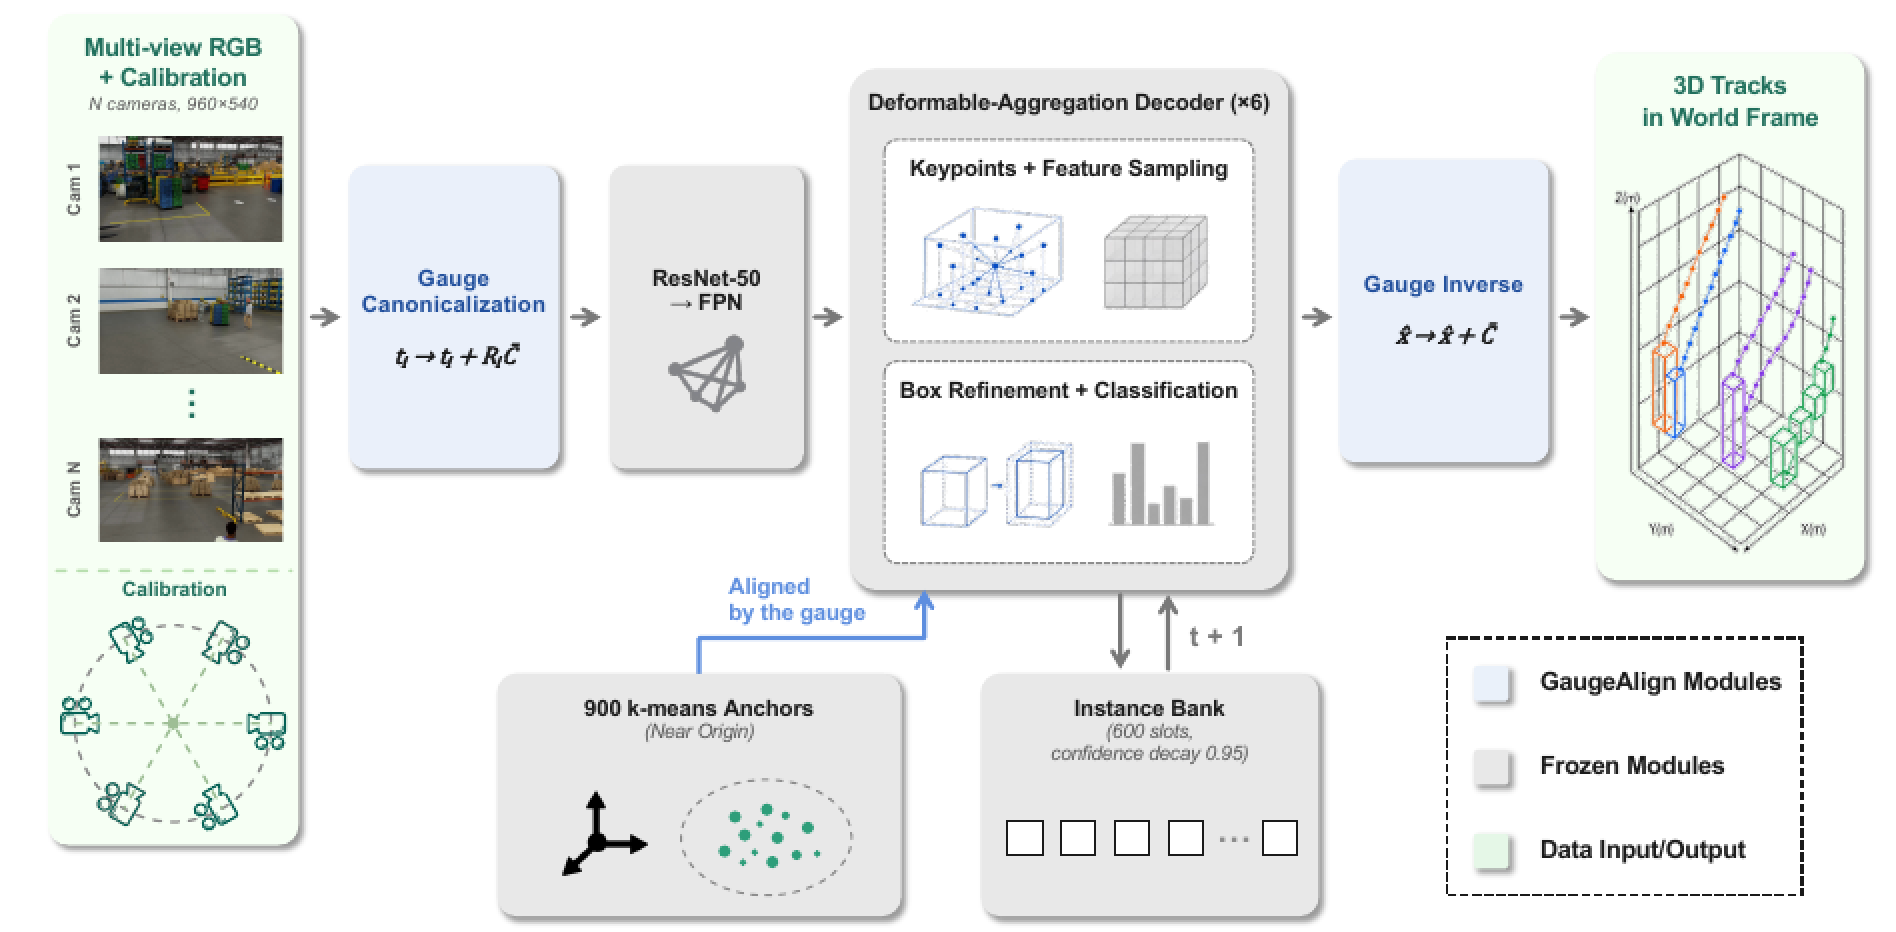
GaugeAlign uses inference-time scene canonicalization to address coordinate-frame sensitivity in multi-camera 3D perception. Our complete system won Track 1 of the 2026 AI City Challenge.
@inproceedings{wu2026gaugealign,title={The Winning Solution for Track 1 of the 2026 AI City Challenge: Gauge Canonicalization for Multi-Camera 3D Perception},author={Wu, Xianjin and Fang, Heng and Xi, Xuanyang and Tang, Yiping and Xu, Di and Bai, Xiang and Liang, Dingkang},booktitle={ECCV Workshop: 10th AI City Challenge},year={2026},}